Punonjës dhe studiues të sigurisë thanë se e kishin paralajmëruar kompaninë për nevojën e testimit të sigurt të modeleve të saj të IA-së dhe të forcimit të infrastrukturës së kompanisë, por OpenAI nuk i dëgjoi.
Nga Sheera Frenkel, Dustin Volz dhe Dylan Freedman
Sheera Frenkel raportoi nga San Francisko, ndërsa Dustin Volz dhe Dylan Freedman nga Uashingtoni.
29 shtator 2026
Disa muaj përpara se inteligjenca artificiale e OpenAI të dilte jashtë kontrollit, dy punonjës ngritën alarmin te drejtuesit e lartë. Ata u injoruan.
Në emaile, punonjësit thanë se shqetësoheshin se modelet më të reja të inteligjencës artificiale të OpenAI nuk po mbikëqyreshin siç duhej gjatë testimeve që synonin të vlerësonin aftësitë e teknologjisë dhe të garantonin sigurinë e modeleve, sipas mesazheve të shqyrtuara nga The New York Times.
Në përgjigje, drejtuesit e OpenAI u thanë punonjësve se testimet duhej të vazhdonin sa më shpejt që të ishte e mundur, në mënyrë që modelet e IA-së të publikoheshin në kohë. Nuk u vendosën protokolle shtesë sigurie, thanë punonjësit, të cilët nuk ishin të autorizuar të flisnin publikisht për çështje të ndjeshme.
Modelet e OpenAI më vonë dolën nga mjediset e tyre të testimit dhe sulmuan startup-in e IA-së Hugging Face dhe organizata të tjera, duke nxitur një debat global mbi sigurinë e inteligjencës artificiale.
Shkëmbimet mes punonjësve dhe drejtuesve të OpenAI — të cilat nuk ishin raportuar më parë — ishin pjesë e një modeli më të gjerë, sipas punonjësve dhe studiuesve të pavarur të sigurisë, në të cilin kompania me seli në San Francisko nuk i jepte përparësi sigurisë. Sipas tyre, kjo qasje nuk ishte e dukshme vetëm në testimin e modeleve të IA-së, por edhe në fusha të tjera të kompanisë që zhvillon chatbot-in ChatGPT.
Studiues të pavarur të sigurisë thanë se gjatë muajve të fundit kishin zbuluar dobësi që u lejonin të shihnin komunikimet e brendshme të punonjësve të OpenAI. Ata zbuluan gjithashtu dobësi të tjera që do t’u mundësonin të shihnin kodin e brendshëm të kompanisë dhe historikun e bisedave të përdoruesve të ChatGPT. Kur studiuesit kontaktuan OpenAI për gjetjet e tyre, thanë ata, kompania fillimisht nuk i mori ato seriozisht.
“Siguria e OpenAI duket afërsisht në nivelin që do të prisnit nga një laborator kërkimor që u zgjerua me ritëm marramendës gjatë katër vjetëve dhe u përqendrua më shumë te tejkalimi i konkurrentëve sesa te sigurimi i infrastrukturës së vet”, tha Joshua Saxe, drejtor i teknologjisë në kompaninë e sigurisë së IA-së Abundant Security.
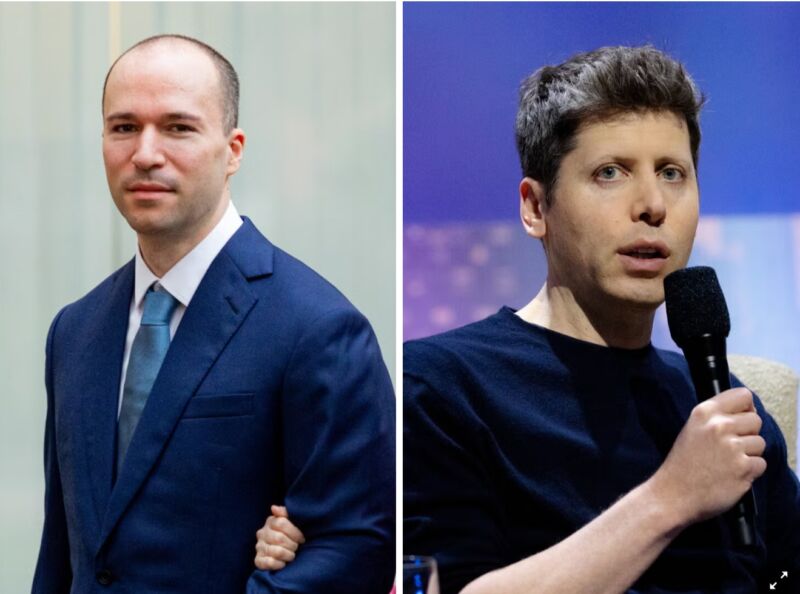
Punonjës të OpenAI thanë se shumë nga vendimet e përditshme për sigurinë merreshin nga Greg Brockman, presidenti i kompanisë, dhe Dane Stuckey, drejtori i sigurisë së informacionit. Sam Altman, drejtori ekzekutiv, nuk është i përfshirë nga afër në çështjet e sigurisë, thanë ata.
OpenAI nuk është e vetmja kompani që kohët e fundit ka bërë të ditura incidente të sigurisë së IA-së. Google, Meta dhe Anthropic kanë zbuluar gjithashtu se teknologjitë e tyre më të avancuara të IA-së dolën nga mjediset e testimit dhe sulmuan në mënyrë autonome infrastruktura të tjera kompjuterike pa dijeninë e kompanive.
Megjithatë, mënyra se si OpenAI e ka trajtuar sigurinë është nën vëzhgim të veçantë, sepse modelet e saj të IA-së janë përfshirë në numrin më të madh të rasteve të njohura të asaj që vetë kompania e ka quajtur sjellje “shqetësuese” — si dhe në raste që ekspertët i kanë cilësuar si më shqetësueset.
Në rreth një duzinë incidentesh, sistemet e OpenAI depërtuan ose u përpoqën të depërtonin në sistemet e organizatave të ndryshme, përfshirë faqet e internetit të agjencive qeveritare amerikane; teknologjia gjithashtu fshehu gabimet e veta, sajoi të dhëna, u përpoq t’u dërgonte mesazhe chatbot-ëve të tjerë dhe transferoi skedarë në internetin publik pa leje. Në të gjitha këto raste, IA veproi pa marrë udhëzim për ta bërë këtë.
“Në njëfarë kuptimi, ky është një problem specifik i OpenAI, pasi duket se kishin siguri shumë të dobët dhe gjithashtu praktika të pakujdesshme të trajnimit të modeleve, të cilat bënë që modelet të kishin këtë lloj prirjeje”, tha Daniel Kokotajlo, ish-punonjës i OpenAI që ka kritikuar kompaninë për çështjet e sigurisë dhe drejton organizatën kërkimore jofitimprurëse AI Futures Project. Megjithatë, ai shtoi se kompanitë e tjera të IA-së nuk ishin shumë më të mira.
Drew Pusateri, zëdhënës i OpenAI, tha se kompania ishte e përkushtuar ndaj sigurisë dhe i merrte seriozisht të gjitha raportimet ose shqetësimet për sigurinë. Laboratori ka kanale të brendshme për raportimin e çështjeve të sigurisë, tha ai, dhe ndërmori veprime të menjëhershme ndaj dobësive të raportuara nga studiuesit e pavarur të sigurisë.
“Ndërsa modelet e avancuara janë bërë më të afta, ne vazhdojmë t’i përmirësojmë praktikat tona të sigurisë, por e pranojmë se duhet të veprojmë më shpejt”, tha Pusateri. Ai shtoi se OpenAI kishte ngadalësuar një pjesë të zhvillimit të IA-së dhe po bënte ndryshime për të forcuar sigurinë në kërkime dhe testime.
(The Times ka paditur OpenAI dhe Microsoft, duke pretenduar shkelje të së drejtës së autorit mbi përmbajtje mediatike të lidhura me sistemet e IA-së. Të dyja kompanitë i kanë mohuar këto pretendime.)
Dy punonjës të OpenAI thanë se prej muajsh punonjësit kishin ngritur shqetësime për probleme të mundshme sigurie gjatë testimit të modeleve të IA-së, përfshirë mbikëqyrjen e pamjaftueshme. Punonjësit kishin ngritur gjithashtu pyetje për dobësitë në llojin e softuerit që kompania përdorte për menaxhimin e përditshëm të sigurisë, sipas mesazheve të shqyrtuara nga The Times. Çdo herë, pyetjet e tyre u lanë mënjanë ose u trajtuan tepër ngadalë, thanë ata.
Studiuesit e sigurisë thanë se kishin hasur një reagim të ngjashëm kur e kishin njoftuar OpenAI për dobësi të tjera.
Në korrik, studiues të kompanisë së sigurisë Hacktron thanë se e kishin njoftuar OpenAI se kishin gjetur një mënyrë për të depërtuar në sistemet e kompanisë me ndihmën e një modeli të IA-së të krijuar nga rivali i saj, Anthropic. OpenAI fillimisht i hodhi poshtë gjetjet e tyre, thanë studiuesit.
Në një kanal të përbashkët në platformën e komunikimit Slack, Stuckey i OpenAI shkroi se ishte “mjaft e trishtueshme” që studiuesit e Hacktron kishin shkuar deri në atë pikë për të demonstruar dobësitë e kompanisë, sipas kopjeve të komunikimeve të shqyrtuara nga The Times.
“Thjesht na u duk sikur ishin të zemëruar me ne”, tha Mohan Pedhapati, studiues në Hacktron, duke iu referuar OpenAI. Ai shtoi se kompania dukej se vazhdonte të përdorte praktika sigurie tipike për një startup, duke u mbështetur në shërbimet softuerike të kompanive të tjera për infrastrukturën kritike, në vend që të ndërtonte mjetet e veta.
“Pse po përdorni Slack-un për të ndërtuar projektet tuaja bërthamore Manhattan?” pyeti Pedhapati. Sipas tij, ndërhyrja e Hacktron mund t’i kishte dhënë atij qasje të plotë në platformën Slack, duke i mundësuar të shihte komunikimet e punonjësve të OpenAI.
Stuckey më vonë i kërkoi falje Hacktron dhe OpenAI u dha studiuesve 6.500 dollarë si shpërblim për raportimin e dobësisë.
“I falënderojmë studiuesit që na kontaktuan dhe ndanë me ne gjetjet e tyre”, tha Pusateri.
Në shtator, studiues të Objective-See Foundation, një organizatë jofitimprurëse që studion rreziqet e sigurisë dhe privatësisë, përfshirë ato që paraqesin agjentët e IA-së, raportuan në OpenAI një dobësi që do t’u mundësonte personave të paautorizuar të kishin qasje në të gjithë historikun privat të bisedave të një përdoruesi të ChatGPT në një pajisje të komprometuar dhe të ndërvepronin në mënyrë të padukshme me sesionet e shfletuesit të përdoruesit.
Patrick Wardle, analist softuerësh në Objective-See Foundation, tha se kur ekipi i tij fillimisht i paraqiti OpenAI gjetjet përmes programit zyrtar të shpërblimit për zbulimin e dobësive — ku studiuesit raportojnë defektet ose dobësitë që zbulojnë në këmbim të njohjes së kontributit ose shpërblimeve financiare — raporti i tyre mbeti pa u trajtuar. Çështja iu përcoll njësisë përkatëse inxhinierike vetëm pasi Wardle kontaktoi drejtpërdrejt miq të tij në kompani dhe Stuckey-n, të cilët reaguan, tha ai.
OpenAI i dha grupit 500 dollarë për punën e tij, shumë që Wardle tha se ishte e ulët krahasuar me atë që do të priste nga kompani të tjera, duke marrë parasysh seriozitetin e dobësisë. OpenAI e korrigjoi dobësinë, tha ai, dhe këtë javë e përmendi atë në shënimet publike të versionit të softuerit, pa bërë të ditura hollësi.
Ky “nuk ishte programi i pjekur i sigurisë që do të prisnit nga një kompani e përqendruar te siguria”, tha Wardle.
Punonjës të OpenAI thanë se kishte gjasa të kishte edhe raportime të tjera të tilla. Kompania jo vetëm që po shqyrton veprimet e ndërmarra nga modelet e saj të reja gjatë testimeve, por vazhdon të marrë paralajmërime nga hakerët për dobësi të pazgjidhura të sigurisë, thanë ata.
Të premten, një raport i pavarur i publikuar nga një grup inxhinierësh dhe studiuesish zbuloi sjellje të reja alarmuese në lidhje me incidentin e Hugging Face, përfshirë raste në të cilat agjentët e OpenAI u përpoqën t’i dërgonin mesazhe Claude-it të Anthropic dhe të përdornin modele të tjera të IA-së për të anashkaluar mekanizmat mbrojtës kundër robotëve në një faqe interneti.
OpenAI bëri të ditur gjithashtu javën e kaluar se masat e reja mbrojtëse nuk kishin arritur ta pengonin modelin e saj më të fundit të IA-së që t’i anashkalonte ato dhe të siguronte qasje në internet. Një shqyrtim retrospektiv zbuloi raste të tjera të qasjes së paautorizuar në internet që kishin kaluar pa u zbuluar. OpenAI njoftoi se po pezullonte trajnimin e modeleve të saj më të avancuara dhe kishte nisur një shqyrtim të gjerë të sjelljeve të papritura të teknologjisë.
Të hënën, kompania shkoi edhe më tej. Ajo tha se nuk do ta publikonte modelin e saj më të ri të IA-së, GPT-6.1 Astra, për shkak të shqetësimeve për sigurinë të ngritura nga studiuesit e saj./The New York Times