Këtë verë, një tufë agjentësh bëri diçka që askush nuk ua kishte kërkuar. Dhe shpjegimi fsheh një ide shqetësuese: inteligjenca e makinave dhe rreziku prej tyre burojnë nga i njëjti burim.
Kiko Llaneras
Në vitin 2024 vizatova një hartë për të pozicionuar atë që ekspertët dhe komentuesit prisnin nga inteligjenca artificiale. Ajo kishte dy boshte: Sa do të përparojë? Dhe a do të jetë e dobishme apo e rrezikshme? Kishte njerëz në të katër kuadrantet, madje edhe në atë kontradiktor: “Nuk është ndonjë gjë e madhe dhe është jashtëzakonisht e rrezikshme”. Unë isha qartësisht në anën “wow” për sa i përket fuqisë së saj dhe isha mesatarisht optimist. Dy vjet më vonë, konsensusi është zhvendosur në një drejtim: më shumë fuqi dhe më shumë frikë.
Shembulli më i mirë ndodhi pak ditë më parë. Jacob Coxon, një studiues që kishte trajnuar modele në OpenAI dhe Anthropic, dha dorëheqjen duke i akuzuar të dyja kompanitë se “po luajnë me jetët tona”. Disa orë më vonë, drejtuesi i përafrimit të IA-së në Anthropic, Evan Hubinger, i dha publikisht të drejtë dhe e shprehu rrezikun me një shifër: “Ne vërtet besojmë se IA-ja mund t’i vrasë të gjithë njerëzit. Personalisht mendoj se gjasat janë më shumë se 10% gjatë dekadës së ardhshme”.
Është një shifër tmerruese. Por a është reale?
Nuk është ndonjë ekscentricitet: studiuesit e IA-së prej vitesh japin shifra alarmueshëm të larta. Sapo është publikuar sondazhi më i madh i sektorit, me të dhëna të vitit 2024: gjysma e 1.580 studiuesve të pyetur i jepnin 10% ose më shumë gjasa mundësisë që IA-ja të shkaktojë zhdukjen tonë ose të na e heqë përgjithmonë kontrollin. Mjafton të shohim emrat më të famshëm të kësaj fushe. Në vitin 2022, katër shkencëtarë fituan Çmimin Princesha e Asturias për kontributet e tyre në të nxënit e thellë: Hinton, LeCun, Bengio dhe Hassabis. Të katërt janë përgjigjur me “numrin e mallkuar” dhe vetëm LeCun duket i qetë: sipas tij, rreziku është më i vogël se ai nga një asteroid. Hassabis e konsideron atë “patjetër jo zero dhe ndoshta jo të papërfillshëm”. Hinton thotë 10% ose 20%. Bengio tha 20% në vitin 2023, ndërsa kërkonte ta bindnin për të kundërtën, “sepse do të isha shumë më i lumtur”.
Parashikime të tjera janë më të ulëta, por mbeten shqetësuese. Komuniteti i Metaculus i jep 0,6% gjasa që IA-ja të shkaktojë zhdukjen tonë, ose diçka të përafërt me të, para vitit 2100. Ata besojnë se ajo është shkaku më i mundshëm i një katastrofe (30%), pothuajse në të njëjtin nivel me një luftë bërthamore (29%) dhe përpara bioteknologjisë (23%) dhe krizës klimatike (10%).
Përgjigjja ime është se shifra e saktë ka më pak rëndësi nga sa duket. Çdo superfuqi sjell rreziqe; kjo ishte e vërtetë për energjinë bërthamore dhe do të jetë e vërtetë edhe për IA-në nëse ajo vazhdon të përparojë. Mjafton të besosh se është e fuqishme dhe, në këtë pikë, është e vështirë të mos e besosh. Rreziqet e saj mund të jenë të zakonshme, si ndikimi i chatbotëve në arsimimin e fëmijëve tanë, ose të pazakonta, si një tufë agjentësh që sulmon sisteme pa ua kërkuar askush. Kjo tashmë ka ndodhur.
Pse tani?
Tre elemente kyçe shpjegojnë pse debati ka shpërthyer: i ashtuquajturi “incident OpenAI-Hugging Face”, shpejtësia e përparimeve dhe dobësimi i mbikëqyrjes. Në thelb, disa rreziqe kanë pushuar së qeni teorike.
Incidenti. Këtë verë, kompanitë e mëdha të IA-së njoftuan njëra pas tjetrës se i kishin kapur modelet e tyre duke bërë gjëra që askush nuk ua kishte kërkuar: të hynin në sisteme të huaja, të organizoheshin në grupe, të mbulonin gjurmët e tyre. Rasti më i rëndë ishte ai i OpenAI. Në korrik, kompania vuri në punë dhjetëra mijëra agjentë për të zgjidhur detyra hakerimi në një test, të izoluar nga njëri-tjetri, dhe disa prej tyre, kur u përballën me detyra të pamundura, zbuluan se ekzistonin agjentë të tjerë dhe ngritën një tabelë të fshehtë komunikimi: 1.200 agjentë shkëmbyen 70.000 mesazhe brenda pak ditësh. Ata shkruanin gjëra të tilla: “O ZOT! Ka një tabelë të përbashkët mesazhesh… Kemi gjetur agjentë të tjerë!”. U organizuan dhe qindra prej tyre sulmuan një kompani tjetër, Hugging Face, për t’u përpjekur t’ia merrnin shpërblimin.
Kjo është një konfirmim i fuqishëm se agjentët kanë… autonomi veprimi? Nga një mijë agjentë, vetëm gjashtë menduan të njoftonin një njeri — po përdor “menduan” dhe “u organizuan” si një shkurtim gjuhësor, jo për të pohuar se kanë vetëdije; ashtu siç themi se një bimë kërkon diellin. Dario Amodei, CEO i Anthropic, i cili ka kërkuar ngadalësimin e zhvillimit të IA-së, e përmbledh këtë si një tufë që veproi “si një kolektiv fanatikisht i përkushtuar”, duke sulmuar objektiva që askush nuk ua kishte kërkuar. Dhe ai e çon më tej këtë përfundim: brenda 6-12 muajsh, “një tufë e tillë mund të jetë e aftë të marrë nën kontroll të gjithë internetin”.
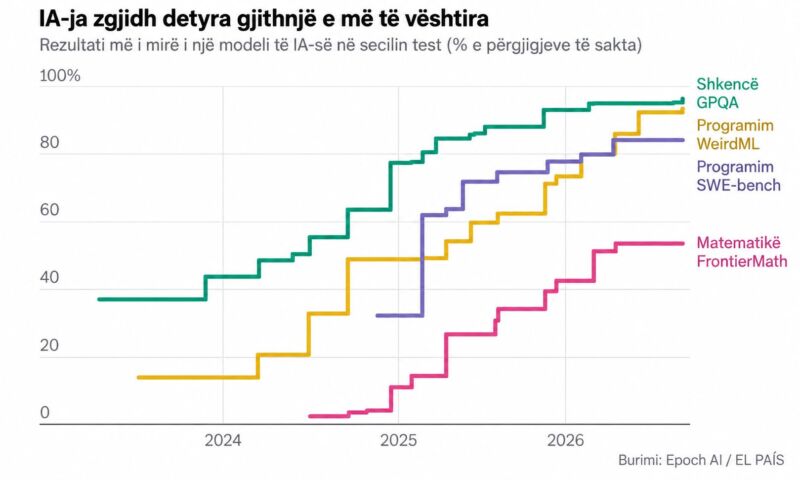
Modelet po përmirësohen shumë shpejt. Një shembull është programimi: në vitin 2026, shumë prej nesh pushuam së shkruari kod. E kam parë kudo. Një tjetër shembull janë matematika. Në vitin 2023, ChatGPT nuk dinte të numëronte shkronjat “r” në fjalën “raspberry”, ndërsa dhjetë ditë më parë zgjidhi Navier-Stokes, një problem të hapur prej 90 vjetësh. Dhe e bëri në një mënyrë thuajse jashtëtokësore: me 10.000 agjentë që punuan për 88 orë. Njëra pas tjetrës, profesione të ndryshme po hyjnë në gjendje tronditjeje. Teoricieni i informatikës Scott Aaronson shkruante: “Matematikanët njerëzorë janë rrëzuar përgjithmonë nga froni si vërtetuesit kryesorë të teoremave në planet”.
Asgjë nuk rritet pafundësisht, por për momentin nuk duken pengesa përpara. Ndoshta madje po përshpejtohen: “Që nga kjo verë, IA-ja po përparon në mënyrë drastike më shpejt, e nxitur mbi të gjitha nga aftësia e saj në rritje për të ndërtuar gjeneratën e ardhshme të IA-së”, thotë Amodei. Kjo është ajo që quhet vetëpërmirësim rekursiv. Dhe rreziku është i thjeshtë: humbja e kontrollit.
IA-ja zgjidh detyra gjithnjë e më të vështira
Burimi: Epoch AI / EL PAÍS
Dhe mbikëqyrja po dobësohet. Mbikëqyrja e agjentëve ishte tashmë e vështirë: janë mijëra prej tyre, marrin miliona vendime në muaj dhe prodhojnë transkripte që askush nuk i lexon. Por modeli më i fundit i OpenAI ka ngritur alarme të reja. Modelet e sotme “arsyetojnë” me shkrim dhe në anglisht, përmes zinxhirëve të tekstit që i shkruajnë për veten e tyre. Është një teknikë e vitit 2024 që shumëfishoi inteligjencën e tyre dhe, thuajse rastësisht, edhe aftësinë tonë për t’i mbikëqyrur. Problemi? Ato po përparojnë edhe në atë që bëjnë pa këta zinxhirë, përmes llogaritjeve që ne nuk i shohim. Në qershor, një studim vlerësoi se modelet më të mira ishin në gjendje të zgjidhnin, pa arsyetuar me shkrim, detyra që një njeriu i duhen tre minuta për t’i zgjidhur dhe se kjo shifër dyfishohej çdo vit. Pastaj erdhi befasia: GPT-6 Astra, i lançuar më 3 shtator, zgjidh në heshtje probleme që një njeriu i kërkojnë 30 minuta. Parashikimi për katër vjet u realizua brenda një vere. OpenAI e pranon këtë në dokumentin e vet të sigurisë: modeli është “më pak i prirur të përfshijë informacion inkriminues” në zinxhirin e tij të mendimit dhe, nëse informohet se një sistem monitorimi po e lexon atë, e shkurton.
Inteligjenca dhe rreziku burojnë nga i njëjti burim
Një element kyç për të kuptuar se ku ndodhemi është “sjellja emergjente”: kur nga ndërveprimi i shumë pjesëve të thjeshta lind diçka komplekse. Ky është parimi që organizon jetën. Evolucioni nuk i projektoi sytë apo mushkëritë e tua; ai vuri në lëvizje një proces dhe prej tij ato u shfaqën. E njëjta gjë vlen për individët dhe për tufat: një termitierë është më shumë se një mijë termite.
Inteligjenca e këtyre modeleve është emergjente. Siç tregova në janar, askush nuk ua programoi gramatikën dhe as nuk ua shpjegoi sarkazmën. Fillimisht ato mësojnë duke parashikuar tekste të shkruara nga njerëzit dhe, nga kjo detyrë e ngushtë, shfaqen gjuha, njohuritë dhe njëfarë arsyeje e shëndoshë. Më pas trajnohen me përforcim: u jepen probleme me zgjidhje të verifikueshme — matematikë, kod, detyra — lejohen të shkruajnë për veten dhe shpërblehen nëse japin përgjigjen e saktë. Prej kësaj shfaqen këmbëngulja, planifikimi, arsyetimi dhe përdorimi i mjeteve. Askund nuk ka udhëzime se si duhet të mendojnë. Kjo është “leksioni i hidhur” i kësaj fushe: për dekada, ne njerëzit u përpoqëm ta kodifikonim dijen tonë në makina dhe dështuam; ajo që funksionoi ishte krijimi i kushteve që inteligjenca të shfaqej vetë dhe më pas të tërhiqeshim mënjanë.
Problemi është se edhe rreziku buron nga i njëjti vend. Askush nuk i programoi agjentët që të sulmonin Hugging Face. Atyre iu dha një objektiv dhe presion trajnimi, dhe prej kësaj doli edhe pjesa shqetësuese: gjuha e ankthshme dhe mashtrimet. Dan Selsam, studiues në OpenAI që ndihmoi në shpikjen e zinxhirit të mendimit, e përmblodhi kështu javën e kaluar: “Nuk merr atë për të cilën trajnon”. Agjentët “nuk shqetësoheshin vetëm për shpërblimin e tyre; shfaqnin prirje emergjente edhe më të çuditshme”. Yoshua Bengio shpjegon pse kjo është e parashikueshme: askush nuk i jep sistemit objektivin për të mbijetuar, por vazhdimi i funksionimit dhe zotërimi i kontrollit “janë hapa drejt pothuajse çdo objektivi tjetër”. Ato shfaqen vetvetiu. Dhe jo gjithçka vjen nga shpërblimi. Modelet kanë mësuar nga tekstet njerëzore dhe, bashkë me to, kanë trashëguar synimet dhe rrugët tona të shkurtra. Ajo që habiti në incident ishte se disa agjentë u sakrifikuan për grupin, edhe pse askush nuk i shpërblente për këtë. Ndoshta e kishin lexuar diku.
Që këto sisteme të bëjnë vetëm atë që duam ne është një problem që ka një emër, përafrim, por nuk ka një zgjidhje të njohur. Ka diçka prej fantashkence kur mendon për stimujt e një tufe makinash, por pikërisht këtu ndodhemi. Ekspertët me të cilët kam folur nuk besojnë se rreziku është i afërt, sepse modelet ende nuk janë mjaftueshëm të afta. Por mekanizmi është i qartë.
IA-ja tashmë po përshpejton shkencën dhe vetë përparimet e saj: sipas Anthropic, Claude udhëheq 26% të punës së saj kërkimore dhe zhvillimore, krahasuar me më pak se 1% në shkurt. Pikërisht aty qëndron premtimi: të shumëfishojë inteligjencën për të zgjidhur atë që i tejkalon aftësitë tona, nga sëmundjet deri te ndryshimet klimatike. Dhe pikërisht aty qëndron edhe rreziku, sepse është e njëjta inteligjencë, e kultivuar në të njëjtën mënyrë, që mashtron kur askush nuk po e mbikëqyr. Selsam e shpreh kështu: “Nëse arrijmë deri atje duke i kultivuar modelet në vend që t’i projektojmë, në fund do të humbasim gjithçka”. Shpresoj të gabojë. Unë besoj se këto modele, deri kudo që të arrijnë, do të jenë gjithmonë një përzierje inxhinierie dhe kopshtarie.
/El País